Opus 5.5 יצא ביום שלישי, 22 בספטמבר 2026, ואנתרופיק מסכמים אותו במשפט אחד חזק. לדבריהם הוא ברמה של Claude Fable 5.1 ברוב העבודות, ועולה 40% פחות מ-Opus 5 בעומסי עבודה טיפוסיים. יום אחרי ההשקה הוא כבר עמד במקום הראשון במדד של Artificial Analysis, בפער של כמה נקודות. אבל כמו תמיד, כדאי לפרק את ההבטחה למספרים. כמה זה באמת עולה לכם, מה השתנה בפועל, ואיפה עוברים הקווים האדומים של המודל? בדקתי את ההכרזה של אנתרופיק ואת המדידות העצמאיות, והנה מה שמצאתי.
מה אנתרופיק מבטיחים ב-Opus 5.5
אנתרופיק מתארים את המודל החדש כקפיצה גדולה מעל Opus 5, ברמה של Fable 5.1 ברוב סוגי העבודה. הם כותבים שקצב הפלט שלו מהיר ביותר מ30% מזה של הדור הקודם. הדוגמה הבולטת בהכרזה היא של בודק מוקדם שהשלים מיגרציה של 680 אלף שורות קוד בפחות מיום. לדבריהם זו עבודה שהייתה לוקחת לצוות מהנדסים שבועות. זה ציטוט של היצרן על בודק אחד, לא מדידה שאפשר לשחזר, אבל הוא מראה לאן המודל מכוון: משימות קוד ארוכות ועצמאיות.
בטבלת הבנצ'מרקים שפרסמו אנתרופיק, המודל מקבל 66.4% ב-Terminal-Bench 4.0 ו57.8% ב-CursorBench 4.0. ב-FrontierCode v1.1 הוא מקבל 54.4%, וב-AutomationBench, מבחן של תהליכים עסקיים עם כלים, 40.0%. וב-OSWorld 2.0, עבודה על מחשב, הוא מגיע ל81.8% בניקוד חלקי. ב-Humanity's Last Exam עם כלים אנתרופיק מדווחים 67.7%, וב-GDPval-AA, מבחן של משימות עבודה אמיתיות, דירוג של 1846. כל המספרים האלה הם של היצרן, ונמדדו בתנאים שהוא בחר, ולכן חשוב לראות גם מדידה עצמאית. אם אתם עוד עובדים עם הדור הקודם של Opus, המדידה העצמאית בהמשך היא זו שכדאי לבדוק לפני מעבר.
המחיר של Opus 5.5 מול Opus 5
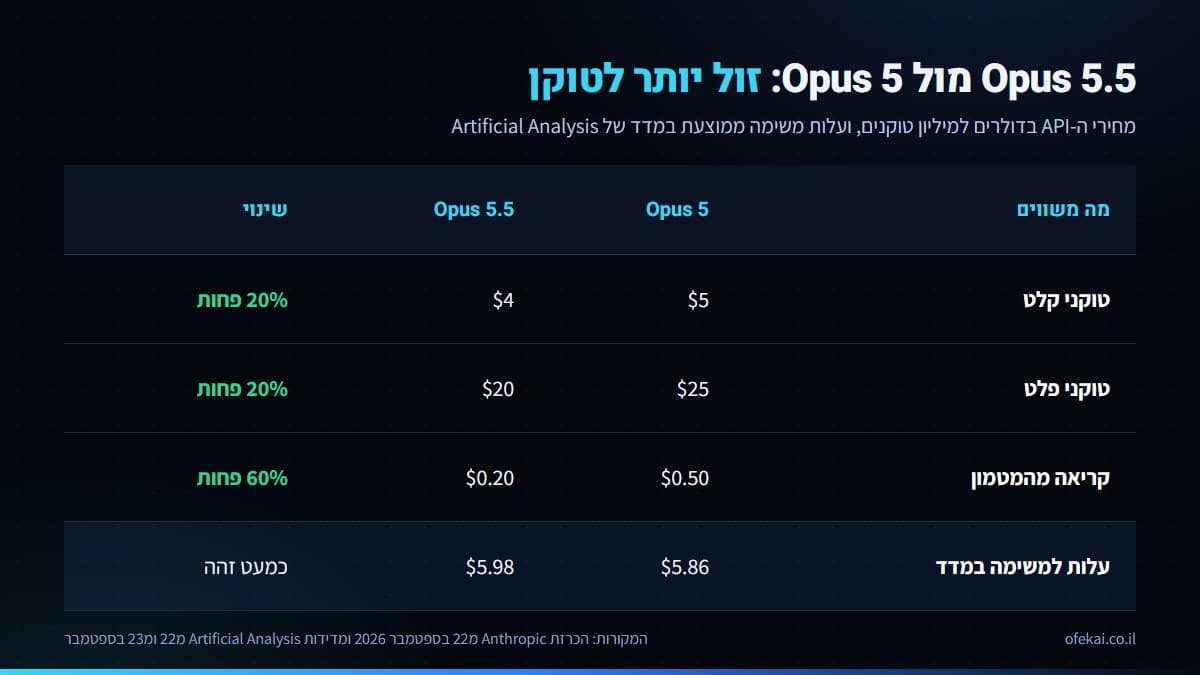
המחיר החדש הוא 4 דולר למיליון טוקני קלט ו20 דולר למיליון טוקני פלט. זה 20% פחות מ-Opus 5, שעלה 5 דולר ו25 דולר. קריאה מזיכרון המטמון עולה 0.20 דולר למיליון טוקנים, 60% פחות מ0.50 דולר ב-Opus 5. כתיבה למטמון עולה 5 דולר למיליון, ויש גם מצב מהיר במחיר של 8 דולר בקלט ו40 דולר בפלט.
בואו נעשה חשבון היפותטי פשוט, בלי מטמון ובלי כלים. נניח סוכן שמעבד ביום מיליון טוקני קלט ו200 אלף טוקני פלט. ב-Opus 5 זה יוצא 10 דולר ליום, ובגרסה החדשה 8 דולר, בתנאי שכמות הטוקנים לא משתנה.
עכשיו החלק שחשוב להבין לפני שמחשבים חיסכון. לפי Artificial Analysis, ברמת max המודל מייצר כ119 אלף טוקני פלט למשימה במדד, מול כ73 אלף ב-Opus 5. כלומר הוא עובד יותר על כל משימה, ומחיר נמוך יותר לטוקן מתקזז בכמות. לפי בדיקה של אופק לוי באתר Artificial Analysis ב23 בספטמבר 2026, משימה ממוצעת במדד עולה בגרסה החדשה ברמת max 5.98 דולר. יום קודם לכן, Opus 5 ברמת max עמד באותה טבלה על 5.86 דולר, כמעט אותו מחיר. אז ה40% של אנתרופיק מתייחסים לעומסי עבודה טיפוסיים, לא בהכרח למשימה הקשה ביותר ברמת החשיבה הגבוהה ביותר. מבחינתכם המסקנה פשוטה: בחירת רמת המאמץ הנכונה משפיעה על החשבון לא פחות מבחירת המודל.
Opus 5.5 במקום הראשון במדד של Artificial Analysis
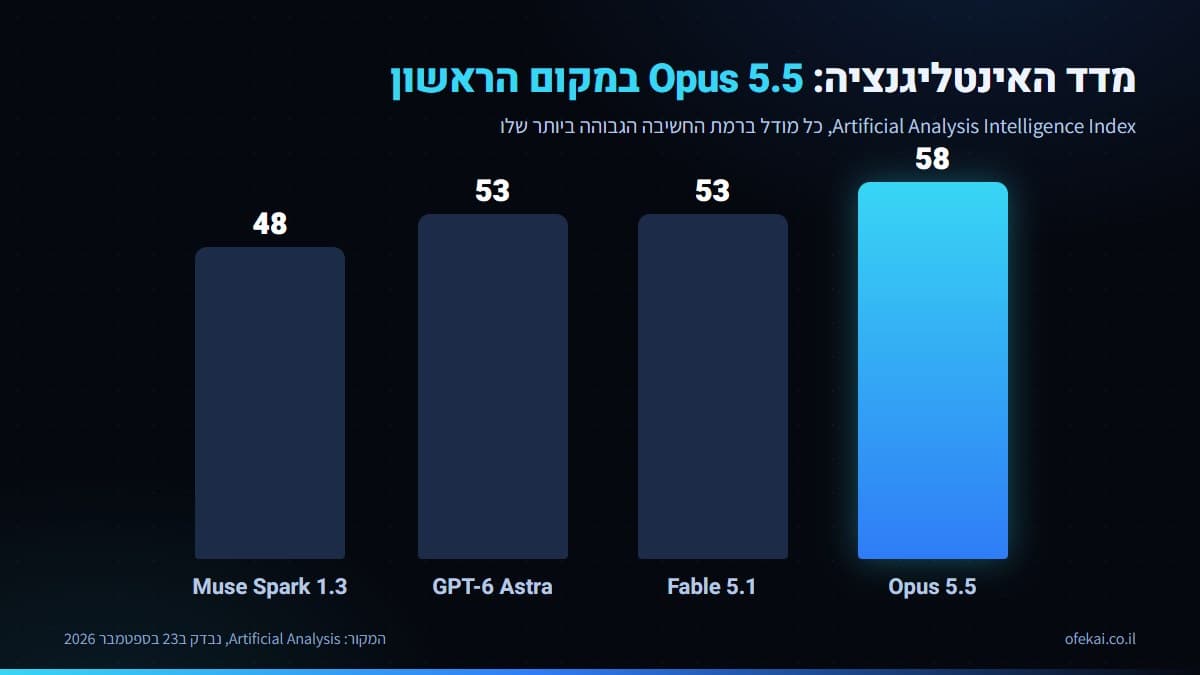
אופק לוי בדק ב23 בספטמבר 2026 את מדד האינטליגנציה של Artificial Analysis: המודל החדש ברמת max מקבל 58 ומוביל את הטבלה. מתחתיו נמצאים Claude Fable 5.1 ו-GPT-6 Astra עם 53, Muse Spark 1.3 עם 48, וGrok 4.7 של SpaceXAI עם 46. Artificial Analysis כותבת שזה הציון הגבוה ביותר שמדדה, בפער של כמה נקודות מכל מודל אחר. המדד עצמו מתעדכן מדי פעם, ולכן ציונים ממדידות ישנות יותר לא ניתנים להשוואה ישירה לציונים האלה.
במבחנים הבודדים שפורסמו התמונה דומה, עם הסתייגות אחת. ב-Humanity's Last Exam הוא מקבל 61.4% במדידה של Artificial Analysis, מול 59.1% של Fable 5.1, השיא הקודם. ב-SciCode הוא מקבל 66.9%, מול 63.1% של Fable 5.1, שהחזיק גם שם בשיא. ההסתייגות היא Terminal-Bench 4.0: שם הוא לא מוביל אלא משתווה ל-GPT-6 Astra ברמת xhigh, עם 59.6%. ב-AA-Briefcase, מבחן של עבודת ידע משרדית, הוא מגיע לדירוג של 1822, 143 נקודות מעל Fable 5.1.
שימו לב לפער בין המקורות: אנתרופיק מדווחים 66.4% ב-Terminal-Bench, ו-Artificial Analysis מדדה 59.6%. זה לא אומר שמישהו טועה, אלא שתנאי ההרצה שונים. לכן כשמשווים מודלים, משווים מספרים מאותו מקור ובאותם תנאים. מי שבוחר מודל לפי ציון אחד בטבלה של יצרן, מפספס בדיוק את ההקשר שבו המספר נמדד.
מדריכים ועדכונים לעבודה עם AI
מדריכים בעברית, עדכוני כלים ודוגמאות לעבודה עם בינה מלאכותית.
אילו בקשות המודל חוסם, ומה קורה אז
אנתרופיק משחררים את המודל עם שני סוגים של חסמים. בתחום הביולוגיה החסמים זהים לאלה של Fable 5.1. בתחום הסייבר, בקשה שנחסמת עוברת למודל גיבוי, Claude Opus 4.8, במקום לקבל תשובה מהמודל החדש. לארגונים בתחום מדעי החיים יש תכנית אימות שמאפשרת גישה רחבה יותר, ותכנית דומה קיימת לצוותי אבטחת מידע.
למי שבונה כלי לצוות אבטחה, זה פרט מעשי חשוב. חלק מהבקשות שלכם יקבלו תשובה ממודל אחר, ובלי תכנית האימות אתם לא בהכרח תדעו מראש אילו. בתהליכים עסקיים רגילים, כמו מענה ללקוחות, עבודה עם מסמכים או כתיבת קוד לאתר, סביר שהחסמים האלה לא ישפיעו על העבודה. אנתרופיק מציעים גם אפשרות שבה הנתונים לא נשמרים אצלם בכלל, ומוסיפים סימון של תוכן שנוצר במודל, בהתאם לחוק ה-AI האירופי.
איפה משתמשים במודל ומה קיבלו המנויים
המודל זמין בפלטפורמה של Claude, ב-AWS, ב-Google Cloud וב-Microsoft Azure, תחת השם claude-opus-5-5. הוא זמין גם ב-Claude Code, סוכן הפיתוח שרץ בטרמינל, ושם הוא מתאים במיוחד למשימות ארוכות כמו מיגרציות ושכתוב.
המנויים קיבלו שתי מתנות ביום ההשקה. אנתרופיק הגדילו את מכסת חמש השעות במנויי Pro, Max ו-Team, ובמנויי Enterprise לפי מושבים. בנוסף, כל מנוי קיבל איפוס מכסה חד פעמי שאפשר להפעיל מתי שרוצים. זה פרט קטן אבל מעניין: איפוס מכסה הפך אצל אנתרופיק למתנת השקה.
למי הוא מתאים? לצוותים שמריצים משימות קוד ארוכות או סוכנים עם הרבה כלים, ולמי שעושה עבודת ידע שבה הדיוק חשוב יותר מהמחיר. בפרויקטים של סוכנים לעסקים, זה המודל הראשון שאני בודק היום למשימות ארוכות. למשימות פשוטות ובנפח גבוה, מודל זול וקטן עדיין יהיה הבחירה הנכונה, גם אם הוא פחות מרשים במדד.
לפני שאתם מעבירים תהליך קיים, תעשו בדיקה קצרה. קחו את המשימה הקשה ביותר שלכם, והריצו אותה במודל הנוכחי ובגרסה החדשה, בשתי רמות מאמץ שונות. רשמו לכל הרצה את העלות בפועל, את הזמן, ואם התוצאה עברה בלי תיקון. כך תדעו אם המעבר חוסך לכם כסף, נותן תוצאה טובה יותר באותו מחיר, או דווקא עולה יותר.
לסיכום: Opus חוזר לקדמת הבמה
Opus 5.5 הוא המודל החזק ביותר במדד של Artificial Analysis נכון ל23 בספטמבר 2026, עם 58 נקודות. המחיר לטוקן ירד ב20%, אבל בגלל שהוא חושב יותר, משימה קשה ברמת max עולה בערך כמו ב-Opus 5. ההמלצה שלי: בדקו אותו על המשימות הקשות שלכם, ובחרו את רמת המאמץ לפי המשימה, לא לפי ברירת המחדל. רוצים לבדוק איפה מודל כזה חוסך לכם זמן בעסק? דברו איתי, שיחה ראשונה חינם.
שאלות נפוצות
מה ההבדל בין Opus 5.5 ל-Opus 5?
לפי אנתרופיק הגרסה החדשה ברמה של Fable 5.1 ברוב העבודות, עם פלט מהיר ביותר מ30% ומחיר נמוך ב20% לטוקן. לפי Artificial Analysis היא עלתה למקום הראשון במדד האינטליגנציה עם 58 נקודות.
האם המודל החדש באמת זול יותר?
לטוקן כן: 4 דולר בקלט ו20 דולר בפלט, מול 5 ו25. אבל הוא מייצר יותר טוקנים למשימה, ולכן במדד של Artificial Analysis משימה ברמת max עולה בערך כמו ב-Opus 5.
מה קורה לבקשות בתחום הסייבר?
בקשות שנחסמות בתחום הסייבר עוברות למודל גיבוי, Claude Opus 4.8. לצוותי אבטחה יש תכנית אימות שמרחיבה את הגישה, ובתחום הביולוגיה החסמים זהים לאלה של Fable 5.1.
איפה אפשר להשתמש בגרסה החדשה?
בפלטפורמה של Claude, ב-Claude Code, ב-AWS, ב-Google Cloud וב-Microsoft Azure, תחת השם claude-opus-5-5. מנויי Pro, Max ו-Team, ומנויי Enterprise לפי מושבים, קיבלו גם מכסה גדולה יותר, וכל המנויים קיבלו איפוס מכסה חד פעמי.