Grok 4.7 הגיע ביום שני, 21 בספטמבר 2026, והשאלה המעניינת עליו היא לא מה הוא יודע לעשות. השאלה היא כמה עולה לו להגיע לתשובה, וכמה זמן אתם מחכים לה. SpaceXAI, החברה שהייתה xAI ונבלעה לתוך SpaceX, מציגה אותו כמודל החזק שלה לתכנות ולעבודת ידע. המחיר לטוקן לא זז מהדור הקודם, אבל המדידות העצמאיות מספרות סיפור אחר לגמרי. בדקתי את המספרים מול ההכרזה הרשמית ומול Artificial Analysis, ואני מביא כאן כל נתון עם המקור והתאריך שלו. כך תוכלו להחליט בעצמכם אם המודל נכנס לתהליכים שלכם, או נשאר לבדיקה בצד.
מה השתנה ב-Grok 4.7 מול הדור הקודם
לפי ההכרזה של SpaceXAI, מודל הבסיס עצמו גדול יותר מזה של Grok 4.6. הוא גם עבר אימון ארוך יותר בלמידת חיזוק, על תערובת משימות קשה יותר. בשיטה הזאת המודל מקבל תגמול על פתרון שהצליח, ולומד לחזור על הדרך שהובילה אליו. החברה כותבת שהוא עובד זמן רב יותר על משימות קשות ובודק את העבודה של עצמו בקפידה רבה יותר. היא מוסיפה שהוא מתמודד טוב יותר עם הקשר ארוך, כלומר שיחות ומסמכים שנמשכים לאורך הרבה טוקנים.
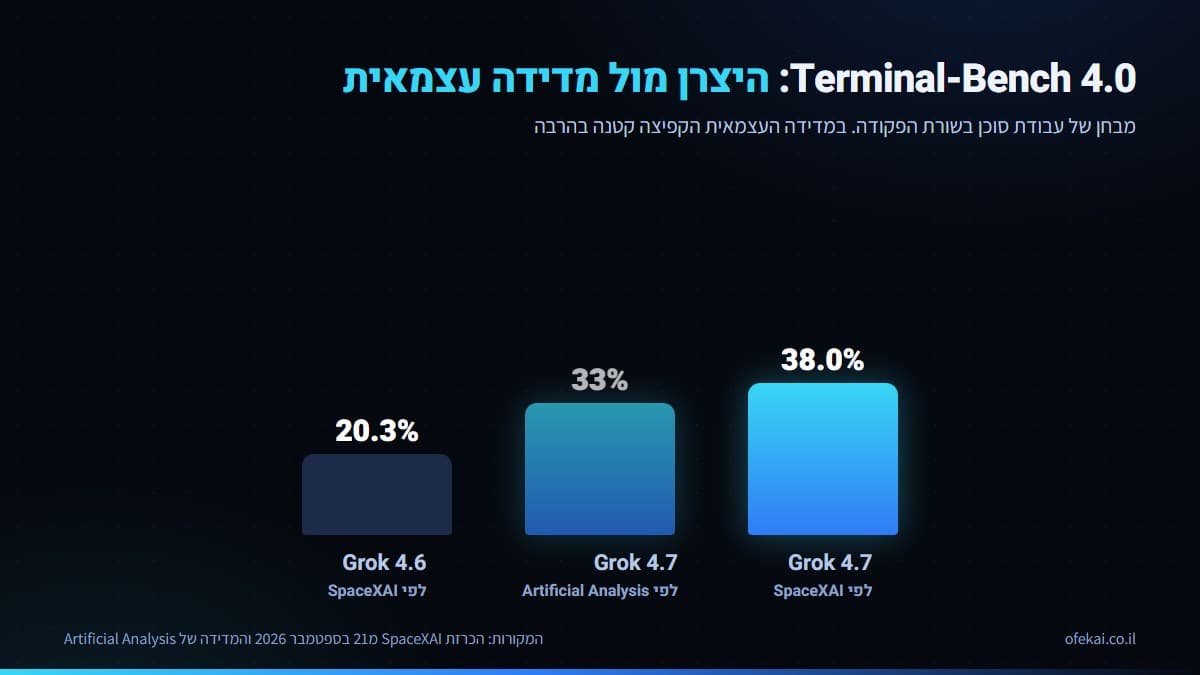
הקפיצה הבולטת בטבלת ההשקה היא ב-Terminal-Bench 4.0, מבחן של עבודת סוכן בשורת הפקודה. לפי היצרן, הגרסה החדשה מקבלת שם 38.0%, מול 20.3% של Grok 4.6, כמעט פי שניים. אבל Artificial Analysis הריצה את המבחן בעצמה וקיבלה 33%, רק 4.5 נקודות מעל Grok 4.6. ב-CursorBench 4.0, מבחן של משימות תכנות ארוכות בתוך עורך קוד, הגרסה החדשה עולה ל46.3% מול 40.4%. גם שם היא לא בראש: באותה טבלה של היצרן, Claude Fable 5.1 מקבל 51.8%. לפי סיקור ההשקה, חלון ההקשר הוא 500 אלף טוקנים, הידע נעצר במאי 2026, והמודל מקבל טקסט ותמונות ומחזיר טקסט. אם עבדתם עם הגרסה הקודמת של המודל, שימו לב ש-SpaceXAI מכוונת את השיפור בעיקר למשימות ארוכות וקשות, לא לשאלה קצרה אחת.
כמה עולה משימה ב-Grok 4.7, ולא רק כמה עולה טוקן
מחירי ה-API זהים לאלה של Grok 4.6: 2 דולר למיליון טוקני קלט ו6 דולר למיליון טוקני פלט. על הנייר זה נשמע זול, ובתעריף לטוקן זה באמת אחד המודלים הזולים בצמרת. אבל מחיר לטוקן הוא רק חצי מהחשבון, כי מודל שחושב ארוך מייצר הרבה יותר טוקנים לכל תשובה.
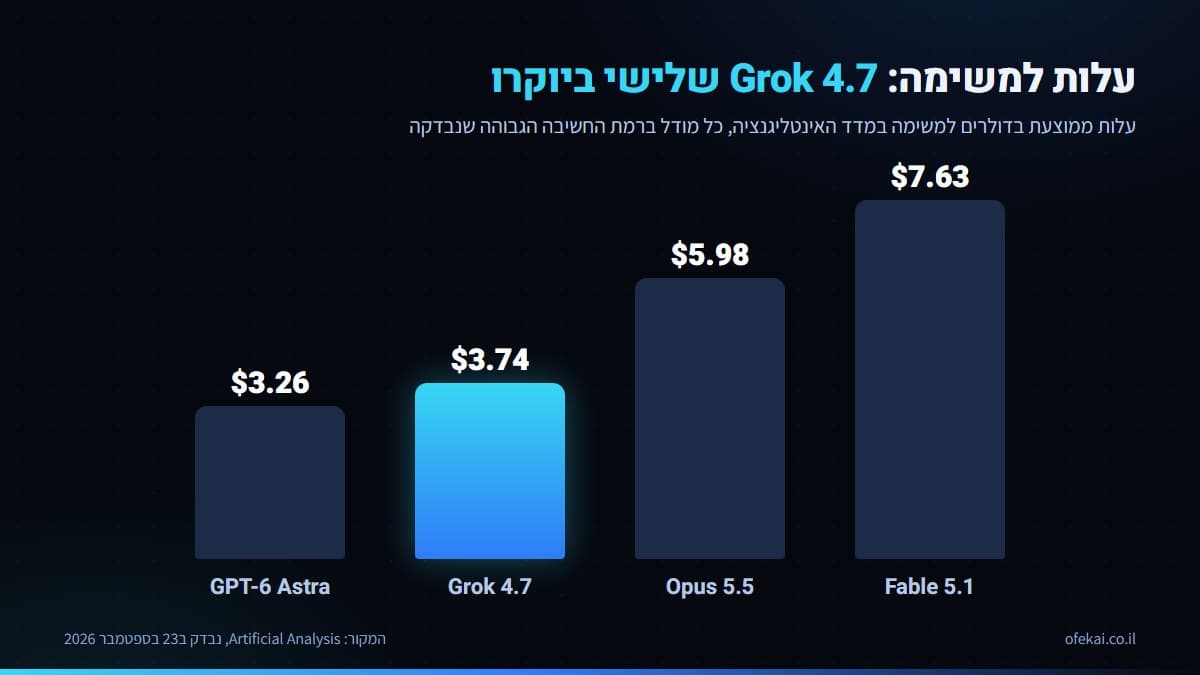
לפי בדיקה של אופק לוי באתר Artificial Analysis ב23 בספטמבר 2026, משימה ממוצעת במדד האינטליגנציה עולה ב-Grok 4.7 ברמת xhigh 3.74 דולר. זה השלישי ביוקרו בטבלה, אחרי Claude Fable 5.1 עם 7.63 דולר ו-Claude Opus 5.5 עם 5.98 דולר. GPT-6 Astra ברמת max, מודל עם ציון גבוה יותר במדד, עולה 3.26 דולר למשימה. הסיבה היא כמות הפלט: לפי Artificial Analysis, המודל ברמת xhigh מייצר כ81 אלף טוקני פלט למשימה. Grok 4.6 הסתפק בכ36 אלף, ו-GPT-6 Astra בכ27 אלף. הנתון המעשי ביותר מבחינתכם: ברמת high אותו מודל עולה 2.73 דולר למשימה, ומקבל את אותו ציון 46 במדד.
בואו נעשה חשבון פשוט, בהנחה שהמשימות שלכם דומות בגודלן למשימות המדד: 100 משימות בחודש. ברמת xhigh זה יוצא 374 דולר, וברמת high זה 273 דולר, על אותו ציון במדד. הפרש של כמאה דולר בחודש לא מופיע באף מחירון, הוא מופיע רק כשמריצים. לכן כשבוחרים מודל לעסק, העלות של המשימה כולה חשובה יותר מהמחיר לטוקן.
מדריכים ועדכונים לעבודה עם AI
מדריכים בעברית, עדכוני כלים ודוגמאות לעבודה עם בינה מלאכותית.
כמה מהיר המודל ומה זה אומר לזמן התגובה
אופק לוי בדק ב23 בספטמבר 2026 את מדד המהירות של Artificial Analysis: Grok ברמת xhigh הפיק 39 טוקני פלט בשנייה. באותה בדיקה GPT-6 Astra עמד על 58 טוקנים בשנייה, ו-Claude Fable 5.1 על 66. ברמת high המהירות עולה ל55 טוקנים בשנייה, וזו עוד סיבה להתחיל ממנה. צריך להגיד גם את ההסתייגות: במאמר של Artificial Analysis על המודל מופיעה מהירות של כ188 טוקנים בשנייה בפרומפטים ארוכים. כלומר המספר תלוי מאוד בתנאי המדידה, ועדיף למדוד על משימה אמיתית שלכם. לפי אותו מאמר, משימה ממוצעת במדד לוקחת בו כשבע דקות, כי הוא מייצר עשרות אלפי טוקנים לפני שהוא מסיים. בבוט שעונה ללקוחות בזמן אמת, המתנה כזאת פשוט לא עובדת. במשימה שרצה ברקע בלילה, לעומת זאת, כמה דקות של המתנה לא מפריעות לאף אחד.
איפה המודל מוביל, ואיפה הוא עדיין מאחור
ומה שהכי הפתיע אותי בטבלה של SpaceXAI הוא דווקא המבחן המשפטי. ב-Harvey Legal Agent, מבחן של סוכנים שמבצעים עבודה משפטית, המודל החדש מקבל 19.6%. GPT-5.6 Sol מקבל באותו מבחן 2.5%, ו-Claude Fable 5.1 מקבל 6.7%. חשוב להגיד שני דברים על המספרים האלה. הראשון, אלה ציונים שפרסם היצרן עצמו, בתנאים שהוא בחר. השני, ציון במבחן משפטי הוא לא אישור להסתמך על תשובה משפטית בלי בדיקה של עורך דין. אם אתם רוצים לבדוק אותו על מסמכים כאלה, התחילו ממשימה שיש לה תשובה ידועה מראש. למשל, חילוץ סעיפי תשלום וסיום מחוזה שכבר עבר בדיקה, והשוואה של הפלט לסיכום שעורך הדין כתב. כך אתם מודדים דיוק, ולא מתרשמים מניסוח משכנע.
בצד הבטיחות, SpaceXAI כותבת שזה המודל החזק ביותר שבדקה בסירוב לבקשות מסוכנות ובעמידות לניסיונות לעקוף את מגבלות הבטיחות. במבחן HackerBench v0.3 הוא נענה רק ל3.3% מבקשות הסייבר שאפשר לנצל גם לפגיעה, לפי אותה הכרזה.
ובמדד הכללי של Artificial Analysis התמונה אחרת: הוא עומד על 46 נקודות, נכון ל23 בספטמבר 2026. מעליו נמצאים, בין השאר, GPT-6 Sol ו-Muse Spark 1.3 עם 48, Fable 5.1 ו-GPT-6 Astra עם 53, וOpus 5.5 שמוביל את הטבלה עם 58. המודלים האלה נבחנו ברמת max, והוא נבחן ברמת xhigh.
איפה משתמשים ב-Grok 4.7 ולמי הוא מתאים
המודל זמין דרך ה-API של SpaceXAI, ב-Cursor, ב-Grok Build, ב-OpenRouter, ב-Vercel וב-Cloudflare. הוא מתגלגל גם ל-GitHub Copilot, לפי ההודעה של GitHub מאותו יום. יש גם גרסה מהירה שמייצרת פלט במהירות כפולה, תמורת מחיר כפול לטוקן. מבחינתי הוא מתאים לסוכנים שמריצים משימה ארוכה ברקע, שבה איכות ההסקה חשובה יותר מזמן התגובה. ניתוח של מסמכים משפטיים הוא דוגמה טובה, בגלל הציון שלו ב-Harvey Legal Agent, כל עוד עורך דין בודק את התוצאה. הוא פחות מתאים לשיחה חיה עם לקוחות, ולתהליך שבו כל משימה צריכה להיכנס בתקציב קבוע ונמוך. כשאני בונה סוכן שמריץ תהליך שלם בעסק, אני בודק שלושה מספרים לפני שאני בוחר מודל: ציון, עלות למשימה וזמן תגובה. הבדיקה שלי היא פשוטה ואתם יכולים לעשות אותה בעצמכם. קחו חמש משימות אמיתיות מהתהליך שלכם, והריצו אותן ברמת high ובמודל שאתם עובדים איתו היום. רשמו לכל משימה את העלות, את הזמן ואם התוצאה עברה בדיקה בלי תיקון. רק אחרי שיש לכם את הטבלה הזאת, יש טעם לדבר על מעבר. לדעתי הציון סביר, אבל העלות והזמן עדיין לא מצדיקים להחליף בו את המודלים שאני עובד איתם ביום יום.
לסיכום: מודל חזק יותר, משימה יקרה יותר
Grok 4.7 משתפר מול Grok 4.6, אבל במדידה העצמאית הקפיצה צנועה יותר מבטבלת היצרן. במדד של Artificial Analysis הוא עלה בשתי נקודות בלבד, ל46. המחיר לטוקן לא השתנה, אבל לפי Artificial Analysis משימה ממוצעת בו עולה 3.74 דולר ברמת xhigh, והמהירות נמוכה. ההמלצה שלי: התחילו ברמת high, מדדו עלות וזמן על משימה אמיתית, ורק אז תחליטו. רוצים לבדוק איזה מודל מתאים לתהליך שלכם, לפני שמשלמים על ניסויים? דברו איתי, שיחה ראשונה חינם.
שאלות נפוצות
מה ההבדל בין Grok 4.7 ל-Grok 4.6?
הגרסה החדשה בנויה על מודל בסיס גדול יותר ועברה אימון חיזוק ארוך יותר. לפי SpaceXAI היא קופצת ב-Terminal-Bench 4.0 מ20.3% ל38.0%, אבל במדידה של Artificial Analysis היא מקבלת במבחן הזה 33%, ובמדד הכללי עלתה בשתי נקודות.
האם הדור החדש יקר יותר מהקודם?
המחיר לטוקן זהה, אבל המשימה יקרה יותר. ברמת xhigh המודל מייצר לפי Artificial Analysis כ81 אלף טוקני פלט למשימה, יותר מפי שניים מ-Grok 4.6, ולכן החשבון הסופי גבוה יותר.
באיזו רמת חשיבה כדאי להתחיל?
ברמת high. לפי Artificial Analysis היא עולה 2.73 דולר למשימה במקום 3.74, מהירה יותר, ומקבלת את אותו ציון 46 במדד האינטליגנציה. עוברים לרמה גבוהה יותר רק אם משימה מסוימת מוכיחה שצריך.
איפה אפשר להשתמש במודל?
דרך ה-API של SpaceXAI, ב-Cursor, ב-Grok Build, ב-OpenRouter, ב-Vercel וב-Cloudflare, והוא מתגלגל גם ל-GitHub Copilot. בכל פלטפורמה כדאי לבדוק את המחיר והמגבלות של הספק עצמו.