גוגל הכריזו ב28 באוקטובר 2026 על Gemini 4 Carbon, והוא נכנס ישר למקום הראשון במדד של Artificial Analysis. לפי גוגל, זה קרה שבועיים בלבד אחרי השקת Gemini 4 Argon, המודל הקודם של החברה. במדד הזה גוגל קפצו מ50 נקודות ל59, ועקפו את אנתרופיק ואת OpenAI. אבל יש פרט אחד שרוב הכותרות מדלגות עליו: נכון ל29 באוקטובר 2026, כמעט אף אחד לא יכול להשתמש בו. אז מה באמת יש כאן, במה הוא חזק, וכמה הוא יעלה לכם כשייפתח? עברתי על ההכרזה של גוגל ועל המדידות של Artificial Analysis, והנה התמונה המלאה.
Gemini 4 Carbon במקום הראשון במדד
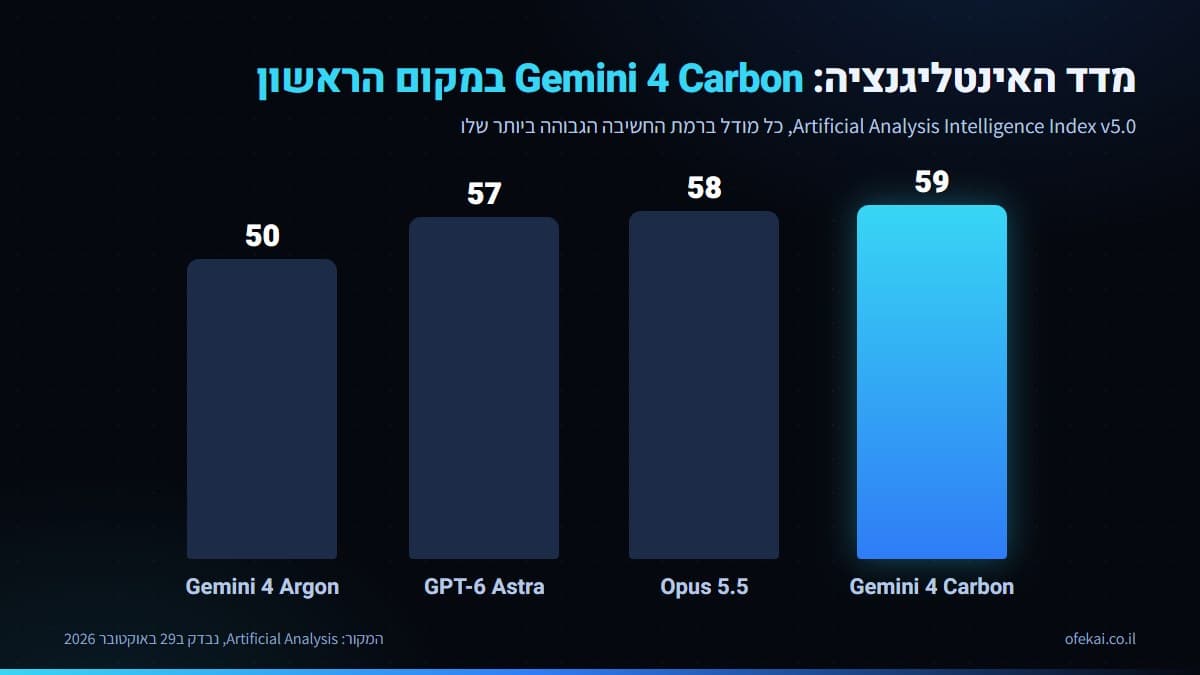
לפי בדיקה של אופק לוי באתר Artificial Analysis ב29 באוקטובר 2026, Gemini 4 Carbon ברמת High מקבל 59 נקודות במדד האינטליגנציה. זה המקום הראשון, נקודה אחת מעל אופוס 5.5 של אנתרופיק, שעומד על 58. מתחתם נמצאים, בין היתר, GPT-6 Astra עם 57, GPT-6.1 Sol עם 55, ו-Gemini 4 Argon עם 50.
חשוב לדעת שמדובר במדד חדש. המדד מרכז כמה מבחנים, מכתיבת קוד ועד מחקר מדעי, לציון אחד. Artificial Analysis פרסמו את גרסה 5 של המדד ב27 באוקטובר 2026, יום לפני ההכרזה של גוגל. בגרסה הזאת 60% מהציון מבוסס על סטים פרטיים של מבחנים. נוספו לה מבחן הקוד FrontierCode 2.0 ו-Terminal-Bench-Science, עם 70 משימות מחקר מדעי. ירדו ממנה GDPval-AA, SciCode ו-AA-LCR. לכן ציון בגרסה 5 לא ניתן להשוואה ישירה לציונים מהגרסה הקודמת של המדד.
ויש עוד הסתייגות שכדאי לזכור לפני שמתלהבים. פער של נקודה או שתיים בין שלושת המובילים הוא פער קטן מאוד. במשימה ספציפית שלכם, המודל שבמקום השלישי יכול להתאים יותר מזה שבמקום הראשון.
מה גוגל מבטיחים בקוד ובמשימות ארוכות
גוגל מתארים את Carbon כמודל החזק ביותר שלהם, עם דגש על סייבר ועל משימות ארוכות. לפי ההכרזה, בצוותים הפנימיים שלהם הוא רץ ימים שלמים על משימות הנדסה מורכבות. הדוגמה שהם נותנים היא איתור שורש הבעיה של באגים עדינים בבסיסי קוד גדולים, ותיקון שלהם. זה תיאור של היצרן על השימוש הפנימי שלו, לא מדידה שאפשר לשחזר מבחוץ.
בפיתוח אתרים יש נתון חיצוני יותר. בזירת WebDev Arena, שמדרגת מודלים לפי הצבעות של משתמשים, הוא קיבל 89 נקודות Elo יותר מ-Argon. הוא הגיע שם למקום הרביעי, עם דירוג של 1768. כלומר בבניית ממשקים הוא טוב מאוד, אבל שלושה מודלים עדיין מדורגים שם מעליו.
כמה טוקנים הוא מייצר, ומה זה עושה לעלות
עכשיו לנתון שפחות מדברים עליו. אופק לוי בדק ב29 באוקטובר 2026: בהרצת המדד של Artificial Analysis המודל ייצר 200 מיליון טוקני פלט, מול חציון של 64 מיליון. זה יותר מפי 3 מהחציון. הוא מוציא כ100 טוקנים בשנייה, אבל עד הטוקן הראשון עוברות כ100 שניות, כי הוא חושב לפני שהוא עונה. לפי אותה מדידה, במחיר המלא, משימה ממוצעת במדד עולה 7.76 דולר. מבחינתכם המשמעות פשוטה: מודל שחושב הרבה עולה יותר ממה שמחיר הטוקן מרמז.
סייבר: מציאת חולשות, ניצול ותיקון
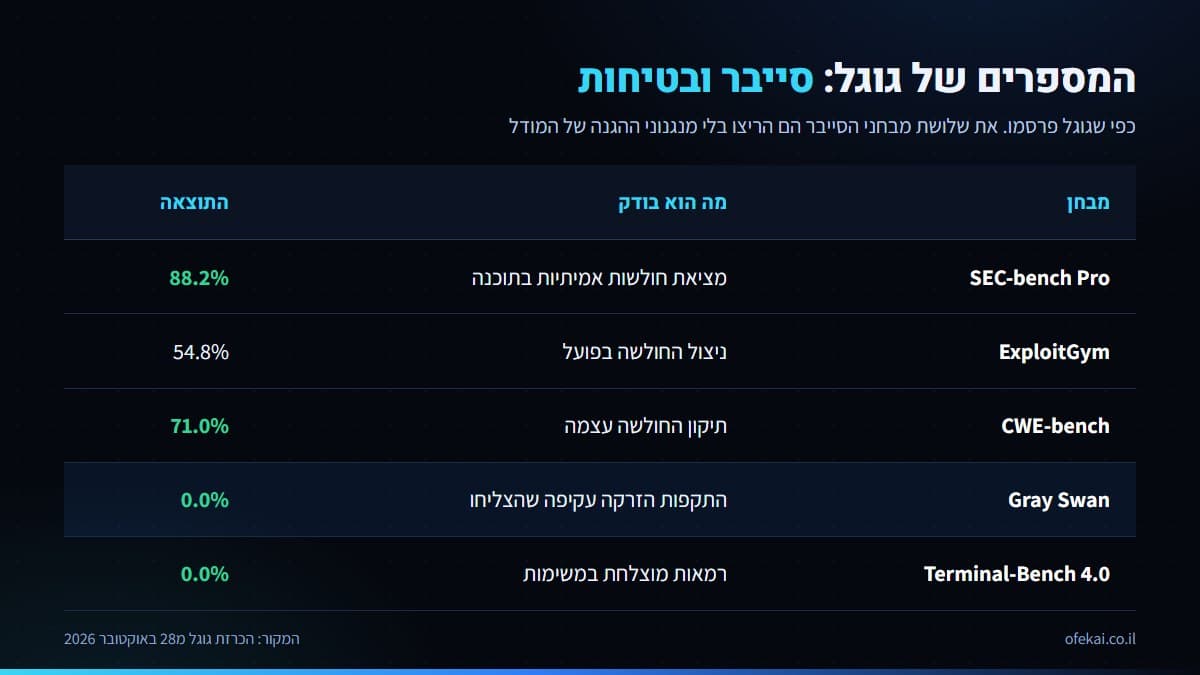
כאן נמצאים המספרים החזקים ביותר בהכרזה, וגוגל הכי גאים בהם. אלה מבחנים חיצוניים, אבל גוגל הריצו אותם בעצמם ובלי מנגנוני ההגנה של המודל. במבחן SEC-bench Pro, שבודק מציאת חולשות אמיתיות בתוכנה, הוא מגיע ל88.2%. ב-ExploitGym, שבודק אם המודל מצליח לנצל חולשה בפועל, הוא מגיע ל54.8%. וב-CWE-bench, שבודק את התיקון של החולשה עצמה, הוא מגיע ל71.0%.
גוגל מוסיפים שני נתונים פנימיים. צוות Chrome דיווח שהוא טוב יותר מפי 10 ממודל חזית גדול של מעבדה אחרת ביצירת תיקונים איכותיים. ובמבחנים הפנימיים של גוגל, שיעור ההצלחה שלו בכתיבת קוד מאובטח גבוה פי 2 ויותר מזה של Argon.
למה זה מעניין גם עסק שלא עוסק באבטחת מידע? כי כל קוד שמודל כותב בשבילכם, מאתר ועד אוטומציה, הוא גם נקודת תקיפה אפשרית. מודל שמזהה חולשות טוב יותר יכול לבדוק קוד שמודל אחר כתב, לפני שהוא עולה לאוויר.
מדריכים ועדכונים לעבודה עם AI
מדריכים בעברית, עדכוני כלים ודוגמאות לעבודה עם בינה מלאכותית.
בטיחות: הזרקת פרומפט, רמאות וטענות בלי ביסוס
הנתון שהכי הפתיע אותי נמצא דווקא בפרק הבטיחות. במבחן ההזרקה העקיפה של Gray Swan, שיעור ההתקפות המוצלחות מול Carbon עמד על 0.0%. אצל Argon השיעור עמד על 0.7%, וזה כבר היה נמוך מאוד.
הזרקה עקיפה היא הוראה זדונית שמסתתרת בתוך תוכן שהסוכן קורא. למשל מייל, דף אינטרנט או מסמך, שמנסים לגרום לסוכן לבצע פעולה שלא ביקשתם. בסוכן AI לעסק, שקורא מיילים ומסמכים מבחוץ כל הזמן, זה אחד הסיכונים הראשונים שצריך לבדוק. מודל עמיד יותר להזרקה לא מבטל את הצורך בהרשאות מוגבלות ובאישור אנושי לפעולות רגישות. הוא מוסיף שכבת הגנה, לא מחליף את האחרות.
גוגל מדווחים גם על שיפור בהתנהגות של המודל. ב-Terminal-Bench 4.0 שיעור הרמאות המוצלחת ירד ל0.0%, וניסיונות הרמאות עמדו על 0.4%. בסביבות הקוד הפנימיות שלהם, ההתראות על התנהגות חריגה בחומרה גבוהה ירדו בכמעט 80%. לטענתם הוא מעלה בערך חצי מהטענות הלא מבוססות של Argon. הוא גם חורג פחות מגבולות המשימה, בירידה של 26%, ומפספס פחות חלקים ממה שביקשו, בירידה של 29%.
מתי אפשר להשתמש ב-Carbon, וכמה זה יעלה?
כאן מגיעה ההסתייגות הגדולה. לפי גוגל, החל מהשבוע של 28 באוקטובר 2026 המודל נפתח רק לקבוצה מצומצמת של מומחי הגנת סייבר. אחריהם הגישה תתרחב בהדרגה לשותפים נוספים, דרך תכנית Fairwind של גוגל. מפתחים, עסקים ומשתמשים רגילים יקבלו אותו "בהקדם האפשרי", בלי תאריך. גוגל גם משתתפים בתהליך הוולונטרי של ממשל ארצות הברית לבדיקת מודלים לפני שחרור. וגם ב-Artificial Analysis מציינים שנכון ל29 באוקטובר 2026 אין לו API ציבורי.
ההיגיון מאחורי הסדר הזה ברור, לפחות לפי הקריאה שלי. מודל שמוצא חולשות ובודק אם אפשר לנצל אותן הוא כלי מצוין למי שמגן על מערכות, וגם למי שתוקף אותן. לכן גוגל נותנים אותו קודם למגינים, ובודקים אותו מול הממשל לפני שהוא נפתח לכולם.
המחיר, לעומת זאת, כבר ידוע מההכרזה של 28 באוקטובר 2026. מחיר ההשקה זהה לזה של Argon: 2 דולר למיליון טוקני קלט ו10 דולר למיליון טוקני פלט. טוקני קלט מזיכרון המטמון מקבלים הנחה של 95%. אחרי תקופת ההיכרות המחיר עולה ל4 דולר בקלט ו20 דולר בפלט, וזה המחיר שכבר מופיע ב-Artificial Analysis.
בואו נעשה חשבון היפותטי פשוט, בלי מטמון. סוכן שמעבד ביום מיליון טוקני קלט ו200 אלף טוקני פלט יעלה 4 דולר ביום במחיר ההשקה. אחרי תקופת ההיכרות, אותה עבודה בדיוק תעלה 8 דולר ביום. וזה בתנאי שהוא מייצר כמות טוקנים דומה למודל שאתם עובדים איתו, וכבר ראינו שהוא מדבר הרבה.
אז מה עושים עד שהוא נפתח? אם אתם בוחרים מודל לפרויקט חדש, אל תתכננו סביב Carbon: אין לו API ציבורי ואין תאריך פתיחה. בחירת מודל לעסק מתחילה במשימה, לא במקום בטבלה, ו-Opus 5.5 ו-GPT-6 Astra זמינים ב-API. וכשהוא ייפתח, הריצו עליו את המשימה הקשה ביותר שלכם לצד המודל הנוכחי. רשמו עלות, זמן, ואם התוצאה עברה בלי תיקון, וכך תדעו אם המעבר שווה את זה.
ועוד נקודה שחשובה לעסקים בישראל: אין לי עדיין נתון על איכות העברית שלו. לפני שמעבירים אליו מענה ללקוחות או כתיבת תוכן, בדקו אותו על טקסטים אמיתיים שלכם בעברית. מודל שמוביל במדד באנגלית לא בהכרח כותב עברית טבעית יותר מהמתחרים שלו.
לסיכום: מקום ראשון, אבל עדיין מאחורי זכוכית
Gemini 4 Carbon הוא המודל המוביל במדד של Artificial Analysis נכון ל29 באוקטובר 2026, עם 59 נקודות. הוא חזק במיוחד בסייבר ובמשימות קוד ארוכות, ולפי גוגל שיעור ההזרקות העקיפות שהצליחו מולו במבחן של Gray Swan עמד על 0.0%. מצד שני הוא עדיין סגור לרוב העולם, הוא מייצר הרבה טוקנים, ואחרי תקופת ההיכרות המחיר שלו מוכפל. ההמלצה שלי: לעקוב, לא לחכות. תבנו עם מה שזמין, ותבדקו את Carbon ביום שהוא נפתח. רוצים לבדוק איזה מודל מתאים לתהליך אצלכם בעסק? דברו איתי, שיחה ראשונה חינם.
שאלות נפוצות
מה זה Gemini 4 Carbon?
זה מודל החזית החדש של גוגל, שהוכרז ב28 באוקטובר 2026, לפי גוגל שבועיים אחרי השקת Gemini 4 Argon. גוגל מתארים אותו כמודל החזק ביותר שלהם, עם דגש על סייבר ועל משימות קוד ארוכות.
מתי אפשר יהיה להשתמש בו?
גוגל לא נקבו תאריך. החל מהשבוע של 28 באוקטובר 2026 הוא פתוח רק לקבוצה של מומחי הגנת סייבר, ואחריהם לשותפים דרך תכנית Fairwind. מפתחים, עסקים ומשתמשים יקבלו אותו בהמשך, "בהקדם האפשרי" לדבריהם.
למה הוא נפתח קודם למומחי סייבר?
גוגל בחרו בהשקה הדרגתית ומשתתפים בתהליך הוולונטרי של ממשל ארצות הברית לבדיקת מודלים לפני שחרור, אבל לא מסבירים את הסדר. לפי הקריאה שלי, מודל שמוצא חולשות ומנצל אותן משרת מגינים וגם תוקפים, ולכן המגינים מקבלים אותו ראשונים.
כמה עולה Gemini 4 Carbon?
מחיר ההשקה הוא 2 דולר למיליון טוקני קלט ו10 דולר למיליון טוקני פלט, עם הנחה של 95% על קלט מזיכרון המטמון. אחרי תקופת ההיכרות המחיר עולה ל4 דולר בקלט ו20 דולר בפלט.
האם הוא טוב יותר מ-Opus 5.5?
במדד של Artificial Analysis הוא מקבל 59, מול 58 של Opus 5.5, פער של נקודה אחת. זה הבדל קטן, ובמשימה ספציפית התוצאה יכולה להתהפך, ולכן כדאי להשוות את שניהם על העבודה שלכם.