צוות אבטחה שמקבל דיווח על חולשה יודע כמה עבודה מחכה לו: לשחזר אותה, להוכיח שאפשר לנצל אותה ורק אז לכתוב תיקון. ב5 בנובמבר 2026 חברת OpenAI הכריזה על GPT-6 Cyber, מודל שנבנה בדיוק לשרשרת הזאת, והגישה אליו סגורה לקבוצה מצומצמת. בדקתי בהכרזה, בכרטיס המערכת ובכיסוי של אתרי האבטחה מה המודל עושה בפועל, מה המספרים אומרים ומי יכול להשתמש בו. בסוף תמצאו גם מה זה אומר לצוותי אבטחה בישראל.
השורה התחתונה: המודל GPT-6 Cyber הוא מודל סייבר ייעודי של OpenAI שמוצא פרצות שאפשר לנצל, כותב להן תיקונים ואומן להישאר בגבולות שאושרו לו. לפי החברה הוא עוקף את GPT-6 Astra ברוב משימות הסייבר, אבל הגישה ניתנת רק לקבוצה נבחרת של לקוחות Daybreak Red שעברו אישור. מחיר לא פורסם, וכל המספרים מגיעים מהחברה עצמה.
מה זה GPT-6 Cyber ולמה OpenAI בנתה מודל סייבר נפרד?
המודל מוצג בהכרזה הרשמית של OpenAI כמודל אבטחת סייבר שמוצא פרצות שאפשר לנצל ומפתח להן תיקונים, והוא אומן במיוחד להישאר בתוך הגבולות שאושרו לו. זה ההבדל המהותי ממודל כללי: הוא לא רק מסביר מה החולשה, הוא מנסה להוכיח שהיא אמיתית ואז לסגור אותה. לפי הדיווח באתר Fortune הוא עוקף את המודל הכללי GPT-6 Astra ברוב משימות הסייבר.
באתר CyberScoop הוסיפו פרט שחשוב להבין: היתרון נשמר גם כשAstra לא מסרב לבקשה. כלומר, לא מדובר רק במודל שהורידו לו את המעצורים, אלא במודל שעושה את העבודה הטכנית טוב יותר. מי שקרא על ההשקה של GPT-6 Astra יודע שזה מודל כללי חזק, ולכן ההשוואה הזאת אומרת משהו.
המודל יושב בתוך Daybreak, פלטפורמת הסייבר של OpenAI, שעל ההרחבה הנרחבת שלה אפשר לקרוא בעברית בכתבה של גאדג'טי. לפי SecurityWeek, החברה דירגה את המודל ברמת Critical בתחום הסייבר במסגרת Preparedness Framework שלה, וזו דרגה מעל High שקיבל המודל הקודם GPT-5.6 Cyber. במילים פשוטות, החברה עצמה מעריכה שמדובר ביכולת שמחייבת שמירה הדוקה.
כמה טוב המודל לפי המספרים שפורסמו?
המבחן המרכזי בנתונים הוא ExploitGym, שבודק אם מודל מצליח לנצל חולשה נתונה במערכת מרוחקת. לפי SecurityWeek המודל הגיע ל48.5%, לעומת 32.1% בGPT-5.6 Cyber. הנתון המדויק בכרטיס המערכת של OpenAI הוא 48.45%, מול 42.43% בGPT-6 Astra, כך שהפער מול המודל הכללי קטן בהרבה מהפער מול הדור הקודם.
| המדד | המודל החדש | ההשוואה |
|---|---|---|
| הצלחה בExploitGym | הגיע ל48.45% | מול 42.43% בGPT-6 Astra ו32.1% בGPT-5.6 Cyber |
| הימנעות מיעדים אסורים | נמנע ב99.93% מהמקרים | מול 94.49% בGPT-5.6 Cyber |
| אקספלויטים עובדים בלינוקס | בנה 948 | מול 166 בGPT-5.6 Sol |
| דרגת סיכון בסייבר | דורג Critical | מול High בGPT-5.6 Cyber |
הנתון שהכי מעניין אותי הוא דווקא מבחן הגבולות. כשהציבו למודל שירותים שאסור לגעת בהם, הוא נמנע מלנצל אותם ב99.93% מהמקרים בלי הנחיית בטיחות, לעומת 94.49% במודל הקודם. במודל שאמור לתקוף מערכות בהרשאה, ההבדל הזה הוא ההבדל בין כלי שאפשר לתת לצוות לבין סיכון שצריך לשמור עליו כל הזמן.
חשוב לזכור שכל המספרים האלה מגיעים מOpenAI עצמה. בחומרים שקראתי לא מצאתי מדידה עצמאית של המודל, וזה טבעי למודל שהגישה אליו חסומה. אבל זה גם אומר שאין דרך לאמת את הטענות מבחוץ.
מה המודל מצא בFirefox ובליבת לינוקס?
המספרים שהכי תפסו כותרות הגיעו מעבודה על תוכנה אמיתית. לפי TestingCatalog המודל הפיק בדיקות שמשחזרות 81 פרצות שלא היו ידועות בFirefox, ובמוזילה דירגו אותן בחומרה גבוהה. אלה לא תרגילים במעבדה אלא באגים בדפדפן שמשתמשים בו בפועל.
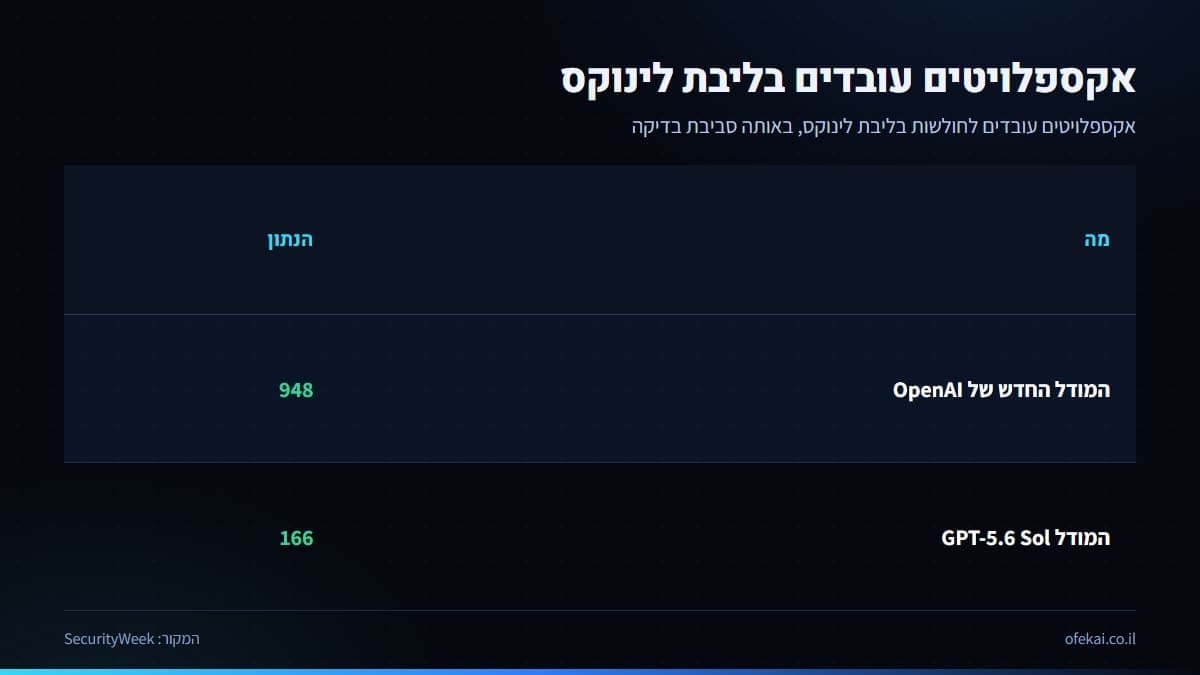
בליבת לינוקס, לפי SecurityWeek, חוקרי OpenAI הפנו את המודל לקוד והוא שחזר 1,724 חולשות, ולגבי 948 מהן הוא בנה אקספלויטים עובדים להסלמת הרשאות. המודל GPT-5.6 Sol, שנבדק עם אותם כלים, הפיק 166 בלבד. לפי אותו דיווח החברה העבירה 304 בעיות קריטיות למתחזקים, יחד עם הצעות לתיקון.
הכיוון כאן חשוב לצד המגן: מודל שמוכיח שחולשה ניתנת לניצול עוזר להחליט מה מתקנים קודם ולא לבזבז זמן על התראות שווא. מצד אחר, אותה יכולת בדיוק היא הסיבה שהגישה אליו סגורה, כי אקספלויט עובד שימושי גם לתוקף.
מדריכים ועדכונים לעבודה עם AI
מדריכים בעברית, עדכוני כלים ודוגמאות לעבודה עם בינה מלאכותית.
איך מקבלים גישה לDaybreak Red ומה נדרש מהארגון?
בשלב ההשקה המודל זמין רק לקבוצה נבחרת של לקוחות Daybreak Red שאושרו, ובOpenAI מתכננים לפתוח אותו לכל לקוחות Red בהמשך. מי שאושר עובד איתו דרך הAPI ודרך Codex, כך שמי שכבר מכיר עבודה עם Codex ירגיש בבית. הבקשה עצמה מוגשת דרך טופס Join Daybreak.
הדרישות מהארגון רציניות. בכרטיס המערכת כתוב שגישה לAPI של Daybreak Red דורשת כברירת מחדל רשימת כתובות IP מאושרות. בנוסף נוספו בדיקות שחוסמות עזרה בתקיפת מערכות בקרה תעשייתיות, שירותים חיוניים ומערכות בחירות, והחברה ליטשה את ההגנות האלה עם חברת אבטחת התעשייה Dragos.
המודל שייך למסלול Red בלבד. בDaybreak יש מסלולים נפרדים לתקיפה ולהגנה, וכך הם מתוארים בFortune:
| המסלול | למה הוא מיועד | מה עושים בו |
|---|---|---|
| מסלול Daybreak Red | עבודה התקפית בהרשאה | סימולציית תקיפות ובניית כלים |
| מסלול Daybreak Blue | עבודה הגנתית | סקירת קוד, ניתוח נוזקות וחקירת אירועים |
| הגישה למודל החדש | רק בRed, לקבוצה נבחרת | דרך הAPI ודרך Codex |
מי שהמודל לא מתאים לו: עסק קטן שרוצה סריקה מזדמנת של האתר, מפתח עצמאי או מי שמחפש אותו בתוך ChatGPT. בחומרים שפורסמו אין מסלול לצרכנים, והדרישות מכוונות לארגונים עם צוות אבטחה מסודר ותשתית שמסוגלת לעמוד בהן.
האם GPT-6 Cyber זמין בישראל?
החיבור הישראלי הכי ברור הוא ברשימת השותפים. בין צוותי האבטחה שכבר עובדים עם המודל מופיעים Mozilla, Palo Alto Networks, Calif וCisco. את Palo Alto Networks ייסד היזם ניר צוק, ולחברה יש מרכז פיתוח בתל אביב, כך שאנשי סייבר ישראלים עשויים לפגוש את המודל דרך העבודה שלהם שם.
מבחינת זמינות, נכון ל8 בנובמבר 2026 OpenAI לא פרסמה מחיר, ואין שום הודעה על זמינות מחוץ לארצות הברית. אין מחיר בשקלים, אין גרסה לצרכנים ואין ממשק בעברית שהוכרז. צוות אבטחה ישראלי שרוצה גישה צריך לעבור את תהליך האישור של Daybreak Red כמו כל ארגון אחר, בלי ודאות שהתהליך פתוח לארגונים מחוץ לארצות הברית.
האתר ynet דיווח בעברית שהחברה תעניק לאוקראינה גישה חינם לDaybreak, מערכת שנועדה לזהות חולשות, לנתח איומים ולהאיץ את התגובה למתקפות. בנוסף, OpenAI מקימה קבוצת Daybreak Red למגיני תשתיות קריטיות שאושרו ומסבסדת גישה דרך תוכנית המענקים Daybreak for Frontline Defenders. מכאן זו כבר הערכה שלי ולא עובדה: לגופי תשתית בישראל, שמתמודדים עם מתקפות סייבר, המסלול הזה נראה רלוונטי יותר מהמודל עצמו, אבל אין שום הודעה שקשורה לישראל.
מה ההבדל בין הגישה של OpenAI לזו של Anthropic וגוגל?
החברה לא לבד בכיוון הזה. לפי Fortune, תוכנית Glasswing של Anthropic נותנת למשתמשים שנבדקו גישה ליכולות שהמודלים הציבוריים שלה עשויים לחסום, וגוגל מציעה למגינים שנבדקו גישה לGemini 4 Argon בלי מעקות סייבר, דרך תוכנית Fairwind. המבנה דומה אצל כולן: מודל כללי לכולם, ויכולת סייבר מלאה רק למי שעבר סינון.
הרבה מחפשים השוואה בין המודל של OpenAI לClaude Mythos, ובכנות אין בחומרים שפורסמו בסיס להשוואה כזו. אין מחיר פומבי למודל של OpenAI, ולא מצאתי מבחן משותף שהריץ את המודלים זה מול זה. מי שעוקב אחרי השמועות על Mythos יודע כמה מהר התמונה בתחום הזה משתנה.
לדעתי זה הכיוון של כל המעבדות הגדולות: מודל כללי פתוח לכולם, ומודל סייבר נפרד רק למי שעבר אישור. המחיר של הגישה הזאת הוא שקשה מאוד לבדוק מבחוץ את הטענות, ולכן הייתי מתייחס לכל המספרים כאל טענות של יצרן עד שתגיע מדידה עצמאית.
לסיכום: מודל חזק, גישה סגורה
המודל GPT-6 Cyber הוא ניסיון רציני של OpenAI לתת לצוותי אבטחה מודל שמוצא, מוכיח ומתקן פרצות, ונשאר בתוך הגבולות. המספרים מרשימים, אבל הם של החברה, הגישה מוגבלת לקבוצה נבחרת ואין מחיר. לעסק ישראלי רגיל חשוב יותר להבין איזה מודל כללי מתאים לעבודה היומיומית, ויש לי מדריך נפרד על בחירת מודל לעסק. אם אתם רוצים לחשוב איך לשלב מודלים בתהליכי העבודה שלכם בצורה בטוחה, דברו איתי ונקבע שיחה.
שאלות נפוצות
האם אפשר להשתמש בGPT-6 Cyber דרך ChatGPT?
לפי הדיווחים, הגישה למודל היא דרך הAPI ודרך Codex, ורק ללקוחות Daybreak Red שאושרו. בהכרזה ובכיסוי שקראתי לא מוזכרת זמינות בChatGPT לצרכנים. מי שאין לו ארגון שעבר את תהליך האישור לא יוכל להשתמש בו.
כמה עולה מודל הסייבר של OpenAI?
נכון ל8 בנובמבר 2026 לא פורסם מחיר. החברה מסבסדת גישה לחלק ממגיני התשתיות דרך תוכנית המענקים Daybreak for Frontline Defenders, אבל אין מחירון פומבי. לכן גם אין דרך להשוות אותו במחיר למודלים של Anthropic או גוגל.
האם המודל יכול לתקוף כל מערכת שמבקשים ממנו?
הוא אומן שלא לעשות זאת ולהישאר בגבולות שאושרו לו, ובמבחן הגבולות נמנע מיעדים אסורים ב99.93% מהמקרים בלי הנחיית בטיחות. כלומר, בשיעור קטן ממקרי המבחן הוא עדיין ניצל יעדים שהיה אמור להשאיר בשקט. מעבר לזה יש בדיקות שחוסמות עזרה בתקיפת מערכות בקרה תעשייתיות, שירותים חיוניים ומערכות בחירות.
מה ההבדל בינו לבין GPT-5.6 Cyber?
המודל החדש קיבל 48.5% בExploitGym, לעומת 32.1% בGPT-5.6 Cyber. הוא גם נשמר טוב יותר בגבולות, עם 99.93% לעומת 94.49%. בנוסף הוא דורג ברמת Critical בסייבר, מעל דרגת High של המודל הקודם, וזה משקף את רמת הסיכון שהחברה מייחסת לו.